Monitoraggio cloud a Modena Full Stack: vedere i problemi prima degli utenti
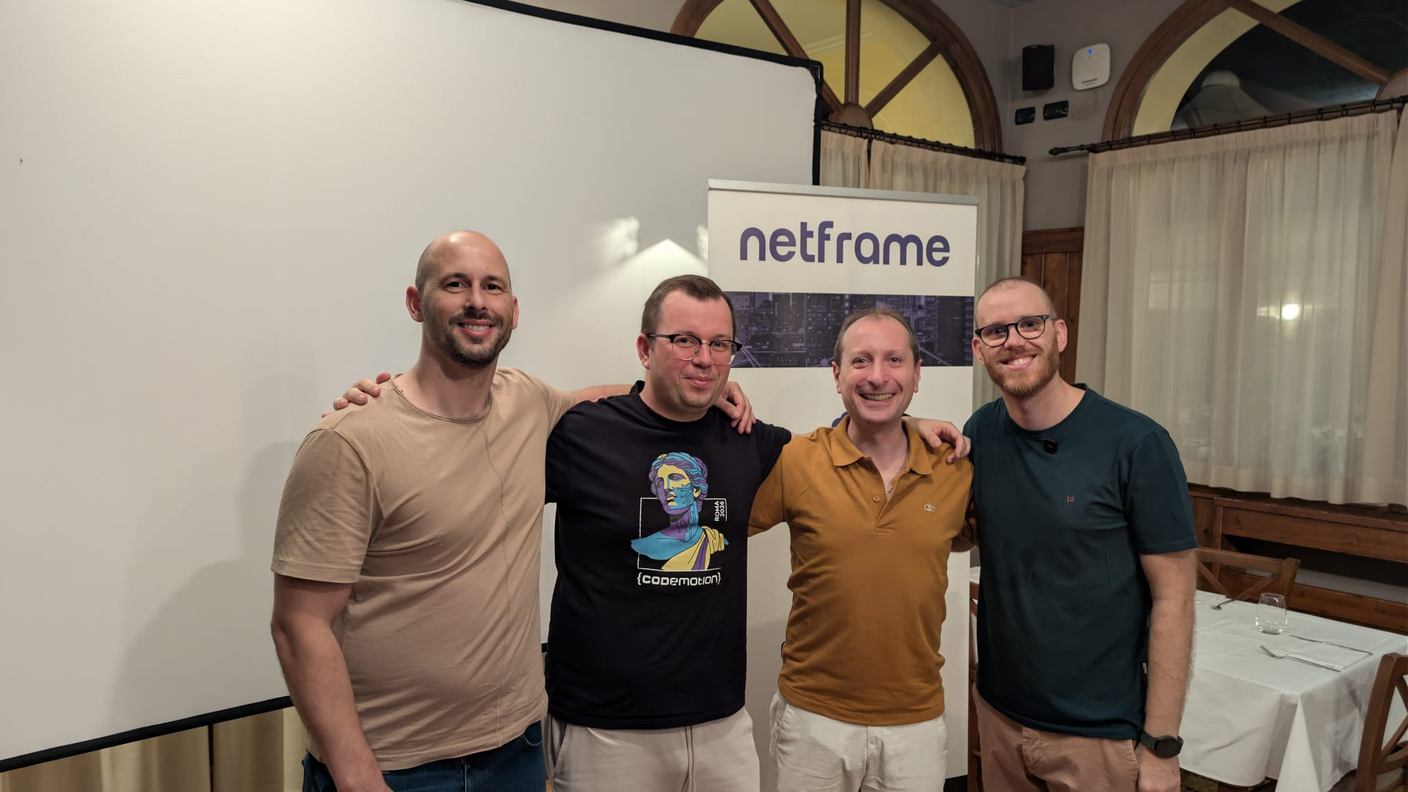
Mercoledì 16 settembre 2026 siamo tornati a Modena Full Stack, il meetup mensile della community IT modenese, questa volta all’Ottantesimo Miglio in via Emilia Ovest. Sul palco Fabio Trigari, platform engineer con un focus su Kubernetes, CI/CD e observability, con un talk dal titolo che è già una promessa: Monitoraggio cloud: come vedere i problemi prima degli utenti.
Netframe ha offerto il primo giro a tutti i presenti, con Webranking co-sponsor della serata. Qui sotto raccontiamo il talk nel dettaglio, con qualche nota tecnica nostra dove serve a chiarire un passaggio.
In breve
- “Il servizio è attivo” non significa che il prodotto funzioni: servono controlli sia dall’interno sia dall’esterno.
- Il monitoraggio white-box legge metriche, log e trace dell’applicazione; il monitoraggio black-box verifica il servizio come lo vede un utente.
- Gli strumenti mostrati: OpenTelemetry, Prometheus con Blackbox Exporter, Grafana, Sitespeed.io, Puppeteer e gli APM New Relic, Datadog e Grafana Cloud.
- I dati diventano utili con dashboard costruite sui Four Golden Signals e con allarmi divisi in Info, Warning ed Error, per non svegliare il reperibile a ogni soglia.
Il Progetto Pippo: cosa succede quando il monitoraggio si rimanda
Il talk parte da una storia che molti in sala hanno riconosciuto. C’è un progetto, lo chiameremo Pippo, e c’è poco tempo: bisogna andare veloci. Il responsabile decide che test e monitoraggio si faranno dopo il rilascio. Il rilascio arriva, il dopo no.
Le slide successive mostrano le conseguenze in sequenza. Prima l’utente che chiama furioso, perché è lui ad accorgersi del guasto. Poi la corda che si sfilaccia, cioè il sistema che regge sempre meno. Poi il tecnico sommerso di allarmi nel cuore della notte, la lettera di dimissioni e i colleghi che parlano male dell’azienda. Il messaggio è chiaro: il costo di un monitoraggio assente non è solo tecnico. Si paga in burnout, in persone che se ne vanno e in reputazione.
Quattro problemi che capitano a tutti
“Solo a me è successo?” chiede Fabio, e mette in fila quattro casi che attraversano l’esperienza di chiunque gestisca servizi in produzione.
| Problema | Esempio | Perché è insidioso |
|---|---|---|
| Errori legati a Java | NullPointerException, OutOfMemoryError: Java heap space | L’errore nasce dentro l’applicazione e spesso cresce lentamente, per esempio con la memoria che sale fino al limite. |
| Microservices death star | Decine di servizi che si chiamano a vicenda | Ogni servizio preso da solo sembra sano, il guasto sta nell’interazione. |
| Aggiornamenti | Nuove versioni di prodotti terzi o del cluster | Il sistema funzionava fino al giorno prima: il problema compare solo dopo il cambiamento. |
| Certificato SSL scaduto | Un certificato che arriva a fine validità | Dall’interno è tutto verde, ma i client rifiutano la connessione. |
Il caso del certificato è stato illustrato con un esempio reale: la root CA DST Root CA X3, arrivata a scadenza il 30 settembre 2021, che mise in difficoltà molti client e sistemi datati. Quanto a Java, la NullPointerException ha una storia celebre: Tony Hoare, l’inventore del riferimento nullo, lo ha definito il suo “errore da un miliardo di dollari”.
Cosa possiamo fare, e perché partire dalla SRE
La risposta immediata è semplice: verificare di continuo che il servizio risponda correttamente e, in caso contrario, mandare un allarme su Teams, via mail, Slack o Telegram. Per farlo bene però bisogna andare in profondità, e Fabio lo fa partendo dalla Site Reliability Engineering.
Riprendendo la definizione di David N. Blank-Edelman nel libro Becoming SRE, la SRE è una disciplina ingegneristica che aiuta le organizzazioni a raggiungere in modo sostenibile il livello di affidabilità appropriato per i propri sistemi, servizi e prodotti. Due parole contano più delle altre.
- Sostenibilità: rendere un sistema affidabile nel tempo, minimizzando lo sforzo e automatizzando il più possibile. Senza automazione il lavoro diventa quello di Sisifo, che spinge il masso in salita per sempre.
- Affidabilità: la raggiungibilità e il corretto funzionamento di un applicativo. Si capisce se un sistema è affidabile solo osservandolo e raccogliendo metriche nel tempo.
La disponibilità aggregata come strumento per decidere
La misura più usata è la disponibilità aggregata: il rapporto tra le richieste andate a buon fine e le richieste totali. Fabio l’ha presentata come una curiosità, ma è uno strumento molto concreto per definire le priorità. Se la disponibilità è pari o superiore all’obiettivo, lo SLO (Service Level Objective), il team può dedicarsi alle nuove funzionalità. Se è inferiore, la priorità passa all’affidabilità: test, correzione dei bug, stabilità.
Per dare un ordine di grandezza agli obiettivi, ecco quanta indisponibilità concede ogni livello di SLO su un mese medio di circa 730 ore (calcolo nostro).
| SLO di disponibilità | Indisponibilità ammessa al mese | Contesto tipico |
|---|---|---|
| 99% | circa 7 ore e 18 minuti | Strumenti interni non critici |
| 99,5% | circa 3 ore e 39 minuti | Applicazioni di reparto |
| 99,9% | circa 43 minuti | Servizi rivolti ai clienti |
| 99,95% | circa 22 minuti | Servizi con impatto economico diretto |
| 99,99% | circa 4 minuti e mezzo | Piattaforme critiche con architettura ridondata |
La piramide della SRE
Il libro Site Reliability Engineering di Google organizza le pratiche in una piramide. Dal basso verso l’alto: monitoring, incident response, postmortem e root cause analysis, testing e procedure di rilascio, capacity planning, development e infine product. Alla base c’è il monitoraggio, perché senza vedere cosa succede nessuno dei livelli superiori può funzionare. Fabio ha raccontato che durante un incidente segue personalmente questa piramide, partendo proprio dal basso.
Perché monitorare
- Se non monitori sei cieco, e l’utente diventa il tuo sistema di allerta.
- Reagire prima che il problema impatti l’utente.
- Analizzare i trend a lungo termine.
- Generare allarmi affidabili.
- Creare dashboard di monitoraggio adatte ai diversi team.
Monitoraggio white-box e black-box: le due tipologie
| White-box monitoring | Black-box monitoring | |
|---|---|---|
| Punto di vista | Dall’interno dell’applicazione | Dall’esterno, come un utente |
| Cosa raccoglie | Metriche, log, trace, eventi | Disponibilità, raggiungibilità, tempo di risposta, status code, contenuto della risposta |
| A cosa serve | Individuare i problemi, prevenire gli errori e capire perché si verificano | Garantire che il servizio sia attivo e funzioni davvero |
| Strumenti mostrati | OpenTelemetry, Prometheus, APM (New Relic, Dynatrace, Grafana Cloud) | Zabbix, Nagios, Blackbox Exporter di Prometheus, APM (New Relic, Datadog, Grafana Cloud) |
| Limite | Non vede ciò che l’applicazione non conosce, come un certificato in scadenza | Dice che qualcosa non va, ma non perché |
White-box: OpenTelemetry, Prometheus e Grafana
OpenTelemetry è uno standard aperto per generare e raccogliere i dati di telemetria: metriche, log e trace. Non è uno strumento di monitoraggio in senso stretto, perché non conserva i dati e non disegna dashboard: li raccoglie e li invia a un sistema di archiviazione e analisi. Proprio perché è uno standard, permette di instrumentare le applicazioni una volta sola e di cambiare in seguito la piattaforma che riceve i dati.
Prometheus è il sistema che raccoglie le metriche a intervalli regolari e le conserva come serie temporali. In Kubernetes, con il Prometheus Operator, cosa monitorare si dichiara con risorse dedicate: il PodMonitor seleziona direttamente i Pod, il ServiceMonitor seleziona i Service e ne legge gli endpoint, tipicamente il percorso /metrics. La sezione Service discovery dell’interfaccia mostra quali target sono stati trovati e con quali label.
Il limite di Prometheus, ha sottolineato Fabio, è l’interfaccia grafica: funzionale per interrogare i dati, poco adatta a leggerli a colpo d’occhio. Qui entra Grafana, che si collega a Prometheus e ad altre sorgenti e trasforma i numeri in dashboard e allarmi. “La vera magia la fa Grafana” è la frase con cui ha chiuso questa parte.
Black-box: il Blackbox Exporter di Prometheus
Il black-box monitoring esegue controlli periodici sul sistema trattandolo come una scatola nera: lo contatta dall’esterno e verifica che risponda nel modo atteso. È meno usato del white-box e non ha capacità predittiva, ma dà la garanzia che il servizio sia davvero raggiungibile.
Lo strumento approfondito nel talk è il Blackbox Exporter, che usa le Custom Resource del Prometheus Operator in due modi:
- ServiceMonitor: ideale per monitorare Service o Pod all’interno del cluster. Con alcune regole di relabeling l’indirizzo scoperto diventa il parametro target della prova, mentre la raccolta vera e propria viene indirizzata al servizio del Blackbox Exporter sulla porta 9115.
- Probe: pensata per il monitoraggio dall’esterno, con i target dichiarati esplicitamente. È più semplice da leggere e non richiede relabeling manuale.
Questa è la Probe mostrata in sala, che controlla ogni 30 secondi due siti pubblici con il modulo http_2xx (la prova riesce solo se la risposta ha uno status code 2xx):
spec:
  interval: 30s
  jobName: probe-p-server
  module: http_2xx
  prober:
    path: /probe
    url: blackbox-exporter-prometheus-blackbox-exporter.monitoring.svc.cluster.local:9115
  targets:
    staticConfig:
      static:
      - https://en.m.wikipedia.org/wiki/Website_monitoring
      - https://grafana.com/
L’exporter ha una sua interfaccia minimale con l’elenco delle prove recenti, l’esito e i log di debug di ogni singola prova. Il risultato più utile però è la dashboard Grafana: per ogni target lo stato, lo status code, la validità del certificato, la versione TLS, i giorni che mancano alla scadenza del certificato, la durata della prova e il tempo di risoluzione DNS. È esattamente il pannello che avrebbe evitato il certificato scaduto dell’inizio: un allarme a qualche settimana dalla scadenza avvisa il team molto prima dell’utente.
Monitoraggio e observability: la domanda dal pubblico
Durante il talk qualcuno ha chiesto quale sia la differenza tra monitoraggio e observability. La risposta di Fabio: il monitoraggio non risponde alla domanda sul perché. Aggiungiamo una precisazione. Il monitoraggio controlla condizioni note in anticipo, con soglie e dashboard; l’observability è la capacità di indagare anche i problemi mai visti, incrociando metriche, log e trace. Il white-box aiuta a capire il perché proprio in quanto fornisce questi dati interni.
Synthetic monitoring: simulare l’utente
Il synthetic monitoring è la forma più evoluta del black-box. Non si limita a chiedere se una pagina risponde: simula il comportamento reale di un utente, verifica che l’intero sistema sia affidabile e non solo i singoli componenti, e permette di testare workflow completi e scenari critici, come un login o un pagamento.
| Strumento | Tipo | Come si crea il test | Cosa si è visto in sala |
|---|---|---|---|
| Sitespeed.io | Open source | Test ripetuti con un browser reale | Report con performance score, peso della pagina, numero di richieste e metriche di caricamento |
| Puppeteer | Libreria open source | Script JavaScript che pilota Chrome | Apertura di una pagina, raccolta degli errori e misura dei tempi |
| New Relic | APM a pagamento | Monitor configurato nella piattaforma | Check falliti per un titolo H1 diverso da quello atteso |
| Datadog | APM a pagamento | Registrazione dei clic, senza codice | Test browser registrato e storico con uptime e tempi per location |
| Grafana Cloud | APM a pagamento | Check configurato nella piattaforma | Uptime, raggiungibilità e metriche Web Vitals della pagina |
Nella slide degli strumenti compare anche Zabbix. L’esempio New Relic merita attenzione: la pagina rispondeva, quindi un semplice controllo di raggiungibilità l’avrebbe data per funzionante. Il test sintetico ha invece verificato il contenuto e ha segnalato che il titolo principale non era quello atteso. È la dimostrazione concreta della frase d’apertura: attivo non vuol dire funzionante.
La dashboard Grafana Cloud mostrava metriche come FCP, LCP, TTFB e CLS, le stesse che Google usa per valutare l’esperienza di una pagina. Una nota nostra: i campi relativi alla reattività all’interazione erano vuoti, ed è normale. Metriche come INP, che dal 2024 ha sostituito FID tra i Core Web Vitals, nascono dall’interazione di utenti reali, e un controllo sintetico che non clicca non le genera.
APM: pronti all’uso, ma a pagamento
Gli strumenti di Application Performance Monitoring monitorano le prestazioni delle applicazioni per rilevare latenza, errori e colli di bottiglia lungo tutto il percorso della richiesta: frontend, backend e servizi esterni.
| Vantaggi | Svantaggi |
|---|---|
| Installazione semplice e veloce, per esempio con Helm in Kubernetes; monitoraggio attivo in pochi minuti; supporto a diverse architetture e piattaforme; individuazione veloce degli errori | Soluzioni spesso a pagamento |
Gli APM consentono sia il monitoraggio white-box sia l’observability. Da una piattaforma all’altra cambia soprattutto l’interfaccia, ma OpenTelemetry è uno standard e quindi i dati raccolti restano confrontabili. Il costo, secondo Fabio, è l’unico vero limite, ed è un limite affrontabile in un contesto enterprise. Il confronto corretto infatti non è tra un abbonamento e zero, ma tra l’abbonamento e le ore che il team spende per installare, aggiornare e mantenere uno stack open source, più il costo di ogni ora di disservizio.
Cosa fare con i dati: Four Golden Signals e dashboard
I dati raccolti servono prima di tutto a costruire dashboard, alcune molto semplici, che mostrino immediatamente lo stato del sistema. Il punto di partenza sono i Four Golden Signals descritti nel libro SRE di Google.
| Segnale | Cosa misura | Esempio |
|---|---|---|
| Latenza | Il tempo necessario per rispondere a una richiesta | Millisecondi di risposta di un’API, separando richieste riuscite e fallite |
| Traffico | Quanta domanda riceve il sistema | Richieste al secondo, sessioni attive |
| Errori | Quante richieste falliscono | Percentuale di risposte 5xx o di risposte con contenuto sbagliato |
| Saturazione | Quanto il sistema è vicino al limite | Occupazione di CPU, memoria, disco, lunghezza delle code |
La slide più efficace della serata era una dashboard a quattro pannelli: latenza verde, traffico regolare, disco a poco più della metà, eppure il 96,6% di errori. Guardando solo i primi tre indicatori il sistema sembrerebbe sano. Anzi, la latenza bassa è probabilmente proprio un effetto degli errori, perché una richiesta che fallisce subito è velocissima. Per questo i segnali vanno letti insieme e la latenza va misurata separando le richieste riuscite da quelle fallite.
Accanto alla vista sintetica serve quella dettagliata. Fabio ha mostrato la dashboard pubblica Mythical Inc. costruita con il metodo RED (Rate, Errors, Duration): richieste, errori e latenze per singolo endpoint. Qui una percentuale di errore globale accettabile si scompone e rivela, per esempio, che proprio il login fallisce molto più degli altri endpoint.
Allarmi senza spam: Info, Warning ed Error
Il talk torna poi al problema iniziale, gli allarmi su Teams, mail o Slack, con un’avvertenza: bisogna evitare di sommergere il team di messaggi. Quando gli avvisi sono troppi, le persone smettono di leggerli e quello importante si perde nel rumore. La soluzione proposta è dividere allarmi ed errori per tipologia, con un’azione diversa per ciascuna.
| Tipologia | Azione | Esempio sul disco |
|---|---|---|
| Info | Il messaggio viene scritto nei log | Disco all’80%: inutile svegliare qualcuno |
| Warning | Si apre un task che verrà preso in carico | Dopo due settimane il disco è al 95%: se ne occupa il team il giorno lavorativo successivo |
| Error | Si chiama il reperibile, perché serve l’intervento umano | Disco al 100%: il servizio è a rischio o già fermo |
Aggiungiamo tre accorgimenti che rendono lo schema ancora più solido. Il primo: far scattare l’allarme solo se la condizione persiste per un certo tempo, così un picco isolato non genera notifiche. Serve poi raggruppare gli allarmi correlati, con Alertmanager, in un unico messaggio. Infine conviene allertare sulla tendenza oltre che sulla soglia. Al 100% il disco è già pieno; con la funzione predict_linear di Prometheus si può chiamare il reperibile quando, al ritmo attuale, il disco si riempirà entro poche ore, mentre una crescita lenta resta un Warning.
groups:
  - name: disco
    rules:
      - alert: DiscoQuasiPieno
        expr: (1 - node_filesystem_avail_bytes / node_filesystem_size_bytes) > 0.95
        for: 30m
        labels:
          severity: warning
      - alert: DiscoPienoEntro4Ore
        expr: predict_linear(node_filesystem_avail_bytes[6h], 4 * 3600) < 0
        for: 15m
        labels:
          severity: critical
La regola pratica che riassume tutto: ogni allarme deve richiedere un’azione. Se un avviso arriva e nessuno deve fare niente, va trasformato in un pannello di dashboard oppure eliminato.
Microservizi: white-box e black-box insieme
In un’architettura a microservizi si adottano entrambe le tipologie, con un’attenzione particolare al white-box, che fornisce il dettaglio di ogni servizio. Il black-box resta però importante per un motivo che spesso si trascura: verifica che il sistema continui a funzionare anche quando non ci sono chiamate da parte degli utenti. Di notte o nel fine settimana, senza traffico, nessuna metrica interna segnala un guasto; la prova esterna invece continua a controllare.
La classificazione finale: dove cade ogni problema
Il talk si chiude tornando ai quattro problemi dell’inizio, disposti lungo una freccia che va dal white-box al black-box.
| Problema | Dove si colloca | Chi lo intercetta |
|---|---|---|
| Errori Java | Estremo white-box | Log, metriche della JVM e trace |
| Problemi dopo un aggiornamento | Verso il white-box | Metriche interne che cambiano subito dopo il rilascio |
| Microservices death star | Verso il black-box | Test sintetici sul flusso completo |
| Certificato scaduto | Estremo black-box | Prova esterna con i giorni alla scadenza |
La conclusione è che non esiste un tipo di monitoraggio migliore dell’altro: ogni problema cade in un punto diverso dello spettro, e per vederli tutti prima degli utenti servono entrambi.
Lo stesso metodo vale per reti, Wi-Fi e telefonia
Il talk parlava di applicazioni cloud, ma chi lavora sulle infrastrutture ritrova gli stessi principi ogni giorno. I Four Golden Signals si applicano identici a una rete o a un sistema di comunicazione: la latenza e il jitter di una chiamata Microsoft Teams, il traffico su un collegamento WAN, gli errori su un trunk SIP, la saturazione di un access point. Anche lo schema Info, Warning, Error si traduce senza fatica: un link al 70% di banda è un dato da dashboard, un trunk che esaurisce i canali nelle ore di punta è un task di capacity planning, un firewall irraggiungibile richiede un intervento immediato.
Le prove black-box sono di casa anche qui: le performance SLA dell’SD-WAN con FortiGate sono di fatto controlli periodici di latenza e perdita di pacchetti che decidono su quale linea instradare il traffico. E sul wireless il principio è lo stesso che descriviamo nella guida su come misurare la copertura e impostare il monitoraggio wifi aziendale: misurare prima che siano gli utenti a segnalare il problema. Sono i criteri con cui progettiamo e collaudiamo reti aziendali, sistemi VoIP e Microsoft Teams Direct Routing.
Per approfondire
Nella slide finale Fabio ha consigliato quattro libri e un progetto:
- Site Reliability Engineering: How Google Runs Production Systems, a cura di Betsy Beyer, Chris Jones, Jennifer Petoff e Niall Richard Murphy
- The Site Reliability Workbook, a cura di Betsy Beyer, Niall Richard Murphy, David K. Rensin, Kent Kawahara e Stephen Thorne
- Building Secure and Reliable Systems, di Heather Adkins, Betsy Beyer, Paul Blankinship, Piotr Lewandowski, Ana Oprea e Adam Stubblefield
- Becoming SRE, di David N. Blank-Edelman
- Il progetto OpenTelemetry
Tutti e quattro i libri sono editi da O’Reilly; i primi tre Google li rende disponibili gratuitamente su sre.google/books.
Grazie, e al prossimo meetup
Un ringraziamento a Fabio Trigari per un talk che ha tenuto insieme teoria, strumenti e codice, con esempi che ognuno in sala poteva riportare nel proprio lavoro. Grazie anche a Modena Full Stack, che mese dopo mese costruisce uno spazio di confronto aperto a sviluppatori, sysadmin e curiosi, e a Webranking per aver condiviso con noi la sponsorizzazione della serata. Se vi siete persi le serate precedenti, trovate i racconti di LLM e AI Agent in 100 righe di codice e de l’importanza di sbagliare.
Chi vuole portare un proprio intervento può candidarsi tramite la call for speakers indicata sulla pagina Meetup del gruppo. Ci vediamo al prossimo appuntamento.
Domande frequenti
Qual è la differenza tra monitoraggio white-box e black-box?
Il monitoraggio white-box guarda il sistema dall’interno: raccoglie metriche, log, trace ed eventi prodotti dall’applicazione e aiuta a capire perché si verifica un errore. Il monitoraggio black-box osserva il sistema dall’esterno, come farebbe un utente: esegue controlli periodici e misura disponibilità, raggiungibilità e tempo di risposta. Servono entrambi, perché alcuni problemi si vedono solo da dentro (un OutOfMemoryError) e altri solo da fuori (un certificato SSL scaduto).
Qual è la differenza tra monitoraggio e observability?
Il monitoraggio dice se qualcosa non va, sulla base di condizioni decise in anticipo: soglie, dashboard e allarmi. L’observability è la capacità di capire perché succede, interrogando metriche, log e trace anche su problemi mai previsti. Il monitoraggio è quindi una parte dell’observability: segnala il sintomo, l’observability permette di arrivare alla causa.
Cosa sono i Four Golden Signals?
Sono i quattro segnali proposti dal libro Site Reliability Engineering di Google per capire a colpo d’occhio lo stato di un servizio: latenza (quanto tempo serve per rispondere), traffico (quanta domanda riceve il sistema), errori (quante richieste falliscono) e saturazione (quanto il sistema è vicino al limite delle sue risorse). Vanno letti insieme: una latenza bassissima può nascondere richieste che falliscono subito.
Come si evita di ricevere troppi allarmi dal monitoraggio?
Si classificano gli eventi per gravità e si decide un’azione diversa per ciascun livello. Nello schema presentato a Modena Full Stack un evento Info finisce solo nei log, un Warning apre un task da gestire in orario di lavoro, un Error chiama il reperibile perché serve l’intervento umano. A questo si aggiungono il raggruppamento degli allarmi correlati, una durata minima prima di notificare e i silenzi durante le manutenzioni. La regola pratica è che ogni allarme deve richiedere un’azione.
Meglio Prometheus e Grafana o un APM a pagamento?
Dipende da competenze, volumi e budget. Lo stack open source Prometheus, Blackbox Exporter e Grafana non ha costi di licenza e lascia il pieno controllo dei dati, ma va installato, configurato e mantenuto dal team. Un APM come New Relic, Datadog, Dynatrace o Grafana Cloud si attiva in pochi minuti e offre dashboard e test sintetici pronti, a fronte di un abbonamento. In un contesto enterprise il costo è spesso giustificato dal tempo risparmiato nell’individuare i problemi. Usare OpenTelemetry per raccogliere i dati riduce il rischio di restare legati a un solo fornitore.
A cosa serve il Blackbox Exporter di Prometheus?
Il Blackbox Exporter esegue controlli dall’esterno su HTTP, HTTPS, TCP, ICMP, DNS e gRPC e restituisce a Prometheus metriche come l’esito della prova, la durata, lo status code e i giorni che mancano alla scadenza del certificato TLS. In un cluster Kubernetes con il Prometheus Operator si configura con due risorse: il ServiceMonitor, adatto a controllare Service e Pod interni al cluster, e la Probe, pensata per il monitoraggio di indirizzi esterni.
Fonti
- Fabio Trigari, “Monitoraggio cloud: come vedere i problemi prima degli utenti”, presentazione a Modena Full Stack, 16 settembre 2026
- Pagina dell’evento su Meetup
- Google, Site Reliability Engineering, Part III: Practices
- Google, libri SRE disponibili gratuitamente
- OpenTelemetry, sito ufficiale del progetto
- Prometheus, Blackbox Exporter (repository ufficiale)
- Prometheus Operator, documentazione
- Grafana, dashboard pubblica Mythical Inc. RED
- web.dev, Web Vitals
Fonti verificate il 16 settembre 2026.
Other Articles
Netframe è Gold Sponsor del DevFest Modena 2026
Zero downtime migrando il DNS in cloud: il racconto della serata Modena Full Stack
Power speaking per informatici: il resoconto della serata Modena Full Stack
Dai sistemi esperti agli LLM: il talk al Reggio Emilia Full Stack
Netframe a Modena Full Stack: LLM e AI Agent in 100 righe di codice
Netframe sponsor del Cinematic Motor Fest 2026 a Modena