Come si misura l’affidabilità di una rete: MTBF, disponibilità, SLA e collaudo
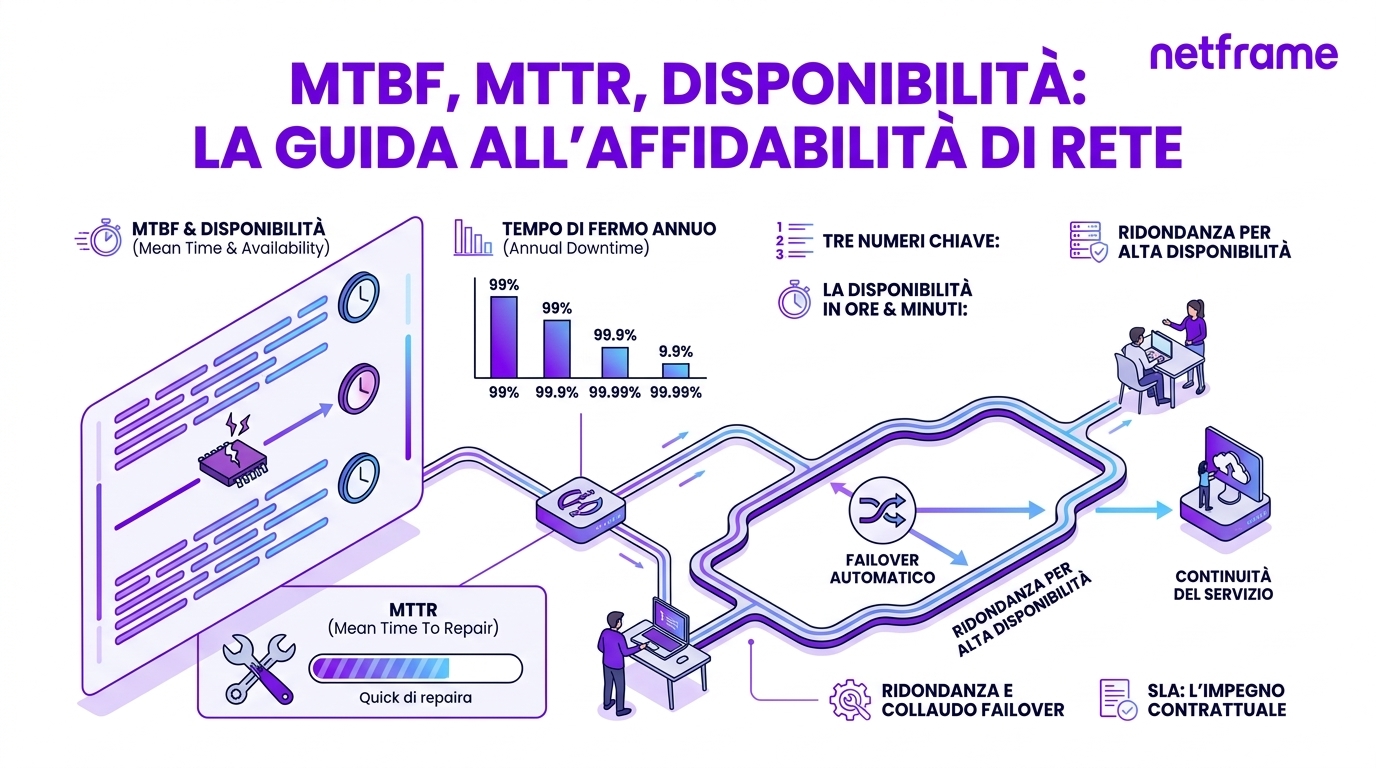
In breve. L’affidabilità di una rete si misura con tre numeri che vengono spesso confusi: l’MTBF (Mean Time Between Failures, tempo medio fra i guasti) dice ogni quanto, in media, si guasta un apparato; l’MTTR (Mean Time To Repair, tempo medio di ripristino) dice quanto si impiega a ripararlo; la disponibilità dice per quale parte del tempo il servizio funziona davvero. L’SLA (Service Level Agreement, accordo sul livello di servizio) è la promessa scritta su quei numeri, e vale quanto le sue esclusioni. Una disponibilità del 99,9 per cento vuol dire quasi nove ore di fermo all’anno; del 99,99 per cento, meno di un’ora. Per arrivarci contano più il tempo di riparazione, la ridondanza e il collaudo del failover che l’MTBF scritto sulla scheda tecnica.
Questa guida è scritta da Netframe, system integrator IT con sede a Modena, per chi deve valutare una rete aziendale o industriale, scrivere un capitolato o leggere un contratto di assistenza. Qui “affidabilità” vuol dire la continuità del servizio di rete per chi lo usa, non l’affidabilità di un software o di un singolo prodotto.
Tre numeri che si confondono
| Termine | Cosa misura | Chi lo fornisce | L’errore tipico |
|---|---|---|---|
| MTBF (tempo medio fra i guasti) | Ogni quante ore, in media, si guasta un apparato di un certo modello | Il produttore, con un calcolo statistico | Leggerlo come durata: 500.000 ore non vuol dire che lo switch dura 57 anni |
| MTTR (tempo medio di ripristino) | Quanto passa da un guasto al servizio di nuovo funzionante | L’organizzazione: ricambi, contratto, persone, documentazione | Confonderlo con il tempo di intervento del fornitore |
| Disponibilità | La parte del tempo in cui il servizio funziona, in percentuale | Si calcola, e poi si misura sulla rete in esercizio | Calcolarla per un apparato e non per il servizio che l’utente usa |
| SLA (livello di servizio) | L’impegno contrattuale su disponibilità, tempi di intervento e di ripristino | Il fornitore, nel contratto | Non leggere dove si misura e cosa è escluso |
I primi tre sono legati da una formula semplice: la disponibilità di un apparato è l’MTBF diviso la somma di MTBF e MTTR. Il quarto è un contratto, e va letto come tale.
La disponibilità in ore e minuti
Le percentuali con molti nove sembrano tutte uguali. Tradotte in tempo di fermo, sono mondi diversi.
| Disponibilità | Fermo massimo in un anno | Fermo massimo in un mese di 30 giorni |
|---|---|---|
| 99 per cento | 87,6 ore, più di tre giorni e mezzo | 7 ore e 12 minuti |
| 99,5 per cento | 43,8 ore | 3 ore e 36 minuti |
| 99,9 per cento | 8,76 ore | 43 minuti |
| 99,99 per cento | 52,6 minuti | 4 minuti e 19 secondi |
| 99,999 per cento | 5,3 minuti | 26 secondi |
Due osservazioni pratiche. La prima: un solo guasto che richiede di ordinare un ricambio consuma in un colpo il margine di un anno al 99,9 per cento. La seconda: sopra il 99,99 per cento nessun intervento umano è abbastanza veloce, e la disponibilità si ottiene solo con apparati doppi e passaggi automatici. È il confine fra una rete “riparata bene” e una rete “ridondata”.
MTBF: cosa dice e cosa non dice
L’MTBF è una grandezza statistica calcolata su una popolazione di apparati, con metodi come Telcordia SR-332 (nato nel settore delle telecomunicazioni statunitensi), IEC 61709 (della IEC, International Electrotechnical Commission, la Commissione elettrotecnica internazionale) o MIL-HDBK-217F (il manuale del Dipartimento della Difesa degli Stati Uniti). Non è la durata di un singolo apparato. Con un tasso di guasto costante, uno switch con MTBF di 500.000 ore ha circa l’1,7 per cento di probabilità di guastarsi in un anno di funzionamento continuo. Su un parco di cento switch uguali, vuol dire aspettarsi in media poco meno di due guasti all’anno.
Tre cautele quando si confrontano schede tecniche. Metodi diversi danno numeri diversi per lo stesso apparato, quindi due MTBF si confrontano solo se sono calcolati con lo stesso metodo e alla stessa temperatura; l’associazione tedesca dell’industria elettrica (ZVEI, Zentralverband Elektrotechnik- und Elektronikindustrie) ricorda che un MTBF senza metodo e condizioni di calcolo non serve a niente. L’MTBF non comprende l’usura: ventole, alimentatori e batterie invecchiano con regole loro. E l’MTBF di un apparato non dice nulla sugli errori di configurazione, che nella pratica fermano le reti più spesso dei guasti.
MTTR: il numero che dipende da voi
Un esempio numerico mostra dove sta la leva. Uno switch con MTBF di 200.000 ore e un tempo di ripristino di 4 ore ha una disponibilità del 99,998 per cento. Lo stesso switch, se il ricambio va ordinato e arriva in tre giorni, scende al 99,964 per cento: quasi venti volte più fermo, con lo stesso apparato.
L’MTTR si accorcia con cose poco tecnologiche: un ricambio a scaffale per gli apparati critici, le configurazioni salvate in automatico, la documentazione della rete aggiornata, un accesso remoto sicuro per chi interviene, un contratto che copre gli orari in cui l’azienda lavora. Il tempo di intervento del fornitore è solo una parte dell’MTTR: il resto è diagnosi, sostituzione, ripristino della configurazione e verifica.
Dal singolo apparato al servizio: la catena
Un utente non usa uno switch: usa una catena di elementi, e basta che se ne rompa uno perché il servizio si fermi. Quando gli elementi sono in serie, le disponibilità si moltiplicano. Cinque elementi al 99,99 per cento ciascuno (per esempio switch di accesso, switch di distribuzione, core, firewall e linea) danno un servizio al 99,95 per cento: la catena è sempre meno disponibile del suo anello più debole.
Quando due elementi lavorano in parallelo e ciascuno basta da solo, si moltiplicano invece le indisponibilità. Due percorsi al 99,9 per cento danno in teoria il 99,9999 per cento. In pratica il conto regge a due condizioni: che i due percorsi non condividano un punto di guasto comune (la stessa alimentazione, la stessa canalina, lo stesso operatore) e che il passaggio dall’uno all’altro funzioni davvero quando serve. La prima condizione si verifica sul progetto, la seconda solo con un collaudo.
Come si progetta la ridondanza negli impianti è spiegato nella guida alle reti industriali ad alta affidabilità e, per gli uffici e le PMI, nella guida alla ridondanza di rete in azienda; per il firewall in coppia c’è la guida al FortiGate in alta disponibilità, per le due linee internet quella sull’SD-WAN per PMI (Software-Defined WAN, Wide Area Network: più linee internet gestite insieme da un solo apparato, nelle piccole e medie imprese).
SLA: cosa leggere nel contratto
Un SLA dice poco finché non si leggono le sue definizioni. Le domande da fare sono sei.
- Dove si misura la disponibilità: sull’apparato del fornitore, sul punto di consegna della linea o dal punto di vista dell’utente?
- Su quale periodo: mese o anno? Il 99,9 per cento su un anno permette un fermo di otto ore in un giorno solo.
- Cosa è escluso: manutenzioni programmate, cause di forza maggiore, guasti su apparati del cliente.
- Tempo di intervento o tempo di ripristino: il primo dice quando arriva qualcuno, il secondo quando il servizio torna.
- Quali orari: ore lavorative, dodici ore al giorno, sempre.
- Cosa succede se l’impegno non è rispettato, e chi produce il rapporto che lo dimostra.
Per chiarezza sul nostro: per i clienti con contratto in Emilia-Romagna Netframe interviene entro 4 ore lavorative. È un tempo di intervento. Il tempo di ripristino dipende dal guasto, dai ricambi disponibili e dalla ridondanza della rete, ed è proprio per questo che nei progetti lo calcoliamo a parte.
Come si misura sulla rete in esercizio
La disponibilità calcolata è una previsione; quella misurata è un fatto. Per misurarla servono tre strumenti che molte aziende hanno solo in parte.
- Monitoraggio degli apparati. Il sistema di monitoraggio interroga switch, firewall e access point a intervalli regolari e registra quando non rispondono, quando si riavviano, quando una porta o un alimentatore cambia stato.
- Sonde di servizio. Misure attive dal punto di vista di chi lavora: un apparato o un software in un reparto che raggiunge a intervalli fissi i servizi importanti (il gestionale, internet, il fleet manager che coordina i robot di magazzino) e registra ritardo, perdita e interruzioni. Misurano la disponibilità del servizio, non del singolo apparato.
- Registro degli incidenti. Ogni fermo con inizio, fine, causa e intervento. È da qui che esce l’MTTR reale, e con il tempo anche l’MTBF reale della vostra rete.
La frequenza di misura conta quanto lo strumento. Con un’interrogazione ogni 5 minuti, un fermo di 3 minuti può non comparire mai nei grafici. Per gli apparati critici si usano intervalli di 30-60 secondi, le notifiche immediate (trap SNMP, Simple Network Management Protocol, e messaggi syslog verso un server centrale) e le sonde di servizio ogni 10-30 secondi; sugli apparati Cisco le sonde si configurano con la funzione IP SLA (misure attive eseguite dall’apparato stesso), sui FortiGate con i Performance SLA dell’SD-WAN (i controlli di prestazione), che misurano ritardo, variazione del ritardo e perdita verso destinazioni scelte.
Per la parte wireless, che ha grandezze sue come segnale, occupazione del canale e roaming, vale la guida al monitoraggio del wifi aziendale.
Il collaudo: le prove che dimostrano i numeri
Una rete dichiarata ad alta disponibilità va collaudata con prove che riproducono i guasti. Le prove di prestazione verificano che il servizio rispetti banda, ritardo, variazione del ritardo e perdita promessi: le metodologie di riferimento sono la raccomandazione ITU-T Y.1564 (ITU-T è il settore standard dell’Unione internazionale delle telecomunicazioni) per l’attivazione dei servizi Ethernet e l’RFC 2544 dell’IETF (Internet Engineering Task Force, l’organismo che pubblica gli standard di internet nei documenti RFC, Request for Comments) per le misure sugli apparati.
Le prove di failover verificano che la ridondanza funzioni. Si mette in rete un traffico continuo e misurabile, poi si stacca un cavo, si spegne un alimentatore, si spegne uno dei due firewall, si fa cadere la linea principale. Per ogni prova si registra quanto è durata l’interruzione vista dal traffico e se il ritorno alla situazione normale avviene senza un secondo fermo. Un failover mai provato non è ridondanza: è una speranza. Per le linee di produzione dove anche pochi millisecondi contano, esistono protocolli a interruzione zero, PRP (Parallel Redundancy Protocol) e HSR (High-availability Seamless Redundancy), descritti nella guida alle reti PRP e HSR.
Il documento di collaudo elenca le prove, i tempi misurati e le soglie concordate prima. È il documento che trasforma un numero del capitolato in una prestazione dimostrata.
Quanto dura un failover: i tempi dei meccanismi
Ogni meccanismo di ridondanza ha un suo tempo di rilevamento del guasto, deciso dai timer. Con i valori di default molti meccanismi impiegano secondi, non millisecondi: è il primo parametro da controllare in un progetto.
| Meccanismo | Timer di default | Rilevamento con i default | Come si accorcia |
|---|---|---|---|
| LACP (Link Aggregation Control Protocol, aggregazione di più link in uno) | Pacchetti di controllo (LACPDU) ogni 30 s, modalità slow | 90 s se il link resta su ma il vicino non risponde | Rate fast: LACPDU ogni 1 s, rilevamento in 3 s |
| RSTP (Rapid Spanning Tree Protocol, IEEE 802.1w, oggi nella IEEE 802.1Q; IEEE, Institute of Electrical and Electronics Engineers) | Hello 2 s | Sotto il secondo se il link cade; 6 s se il link resta su | Link punto-punto, porte edge sugli utenti |
| MRP (Media Redundancy Protocol, IEC 62439-2), anelli industriali | Profilo 200 ms, fino a 50 nodi | Ripristino massimo garantito dal profilo | Profili a 30 o 10 ms dove supportati |
| PRP e HSR (IEC 62439-3) | Nessuno: frame duplicati | Zero interruzione | Già al minimo |
| VRRP (Virtual Router Redundancy Protocol, RFC 5798) | Advertisement 1 s | Circa 3,6 s con priorità 100: tre intervalli più lo skew time | Intervalli sotto il secondo, se gli apparati li supportano |
| HSRP (Hot Standby Router Protocol, Cisco) | Hello 3 s, hold 10 s | 10 s | Timer in millisecondi o BFD (Bidirectional Forwarding Detection, rilevamento rapido dei guasti) |
| OSPF (Open Shortest Path First, protocollo di instradamento) | Hello 10 s, dead 40 s | 40 s se il link resta su | BFD (RFC 5880): per esempio 3 × 50 ms, rilevamento in 150 ms |
Il guasto silenzioso
Il caso che inganna è il guasto silenzioso: il link fisico resta acceso, ma dall’altra parte l’apparato non inoltra più traffico. È lì che contano i timer dei protocolli, ed è lì che i default portano a decine di secondi di fermo. Il tempo di commutazione dei firewall in coppia e delle due linee internet dipende dai timer di heartbeat e dai controlli di raggiungibilità configurati: va misurato, non letto sulla scheda.
Come si misura il tempo di interruzione
Il metodo più semplice è un flusso di pacchetti a cadenza fissa attraverso il percorso ridondato. Da un computer Linux, ping -i 0.01 verso un indirizzo dall’altra parte della rete invia 100 pacchetti al secondo (con le versioni di ping più vecchie servono i privilegi di amministratore per intervalli sotto 0,2 s): ogni pacchetto perso durante la prova vale 10 millisecondi di interruzione. Per le misure di perdita e variazione del ritardo sotto carico si usa iperf3 in UDP (User Datagram Protocol, il trasporto senza ritrasmissioni usato da voce e video), con banda e durata fissate (per esempio iperf3 -u -b 10M -t 60).
La prova si ripete per ogni guasto simulato e per il ritorno alla situazione normale, che a volte provoca una seconda interruzione quando l’apparato primario riprende il ruolo. Soglie di esempio da concordare prima: verde sotto i 200 ms per una rete d’ufficio con voce, giallo fino a 1 s, rosso oltre; per le celle di produzione la soglia la dà il timeout dichiarato dal costruttore della macchina.
Nelle reti industriali: la disponibilità della linea
In fabbrica la domanda giusta non è “quanto è disponibile la rete” ma “quanto è disponibile la rete per quella linea”. Una cella di produzione ha la sua catena: gli switch della macchina, lo switch di reparto, il collegamento al server di supervisione, a volte la radio per i veicoli. Il calcolo e la misura vanno fatti per ogni catena che, se si ferma, ferma la produzione.
Il secondo passo è pesare il fermo. Un’ora di rete ferma in ufficio e un’ora di linea ferma non costano uguale, e il livello di ridondanza si decide confrontando quanto costa il fermo con quanto costa evitarlo. L’architettura complessiva, con la separazione fra uffici e produzione, è descritta nella guida alla progettazione di reti industriali IT/OT (IT è l’informatica d’ufficio, OT la tecnologia operativa: macchine, controllori e supervisione).
Per la PMI: da dove partire
- Elencare i servizi che non possono fermarsi e, per ognuno, quanto fermo è accettabile in un anno.
- Disegnare la catena di ogni servizio e trovare gli elementi singoli, quelli senza un secondo pronto a subentrare.
- Stimare l’MTTR reale di quegli elementi: ricambi, contratto, orari, configurazioni salvate.
- Decidere dove conviene accorciare l’MTTR e dove serve ridondanza, partendo dai servizi più costosi da fermare.
- Collaudare il failover e misurare nel tempo con monitoraggio, sonde e registro degli incidenti.
Come lavora Netframe
Netframe progetta reti aziendali e industriali in tutta l’Emilia-Romagna partendo dai servizi che non possono fermarsi: calcola la disponibilità della catena, individua i punti singoli di guasto, propone dove serve ridondanza e dove basta accorciare i tempi di ripristino. Installa apparati Cisco, Huawei e Fortinet, di cui è partner certificato, collauda il failover con prove documentate e imposta il monitoraggio. La posa dei cavi è affidata a installatori qualificati coordinati da Netframe.
Il servizio di rete è descritto nella pagina Reti aziendali. L’assistenza per i clienti con contratto in Emilia-Romagna interviene entro 4 ore lavorative.
Domande frequenti sull’affidabilità di una rete
Come si misura l’affidabilità di una rete?
Con tre grandezze: l’MTBF, che dice ogni quanto in media si guasta un apparato; l’MTTR, che dice quanto si impiega a tornare in servizio; la disponibilità, che dice per quale parte del tempo il servizio funziona. La disponibilità si calcola in progetto e si misura in esercizio con il monitoraggio degli apparati, le sonde di servizio e il registro degli incidenti.
Cosa vuol dire una disponibilità del 99,9 per cento?
Che il servizio può restare fermo fino a 8,76 ore in un anno, circa 43 minuti al mese. Al 99,99 per cento il fermo scende a 52,6 minuti all’anno, al 99,999 per cento a poco più di 5 minuti. Sopra il 99,99 per cento servono apparati doppi e passaggi automatici, perché nessun intervento umano è abbastanza veloce.
Che differenza c’è fra MTBF e durata di un apparato?
L’MTBF è una media statistica calcolata su una popolazione di apparati, con un metodo come Telcordia SR-332 o IEC 61709. Non è la durata: uno switch con MTBF di 500.000 ore ha circa l’1,7 per cento di probabilità di guastarsi in un anno. L’MTBF non comprende l’usura di ventole, alimentatori e batterie, e due valori si confrontano solo se calcolati con lo stesso metodo.
Come si calcola la disponibilità di una rete con più apparati?
Per gli elementi in serie le disponibilità si moltiplicano: cinque elementi al 99,99 per cento danno il 99,95 per cento. Per gli elementi in parallelo, dove ciascuno basta da solo, si moltiplicano le indisponibilità: due percorsi al 99,9 per cento danno in teoria il 99,9999 per cento, a patto che non abbiano guasti in comune e che il failover sia stato collaudato.
Cosa controllare in un SLA di rete?
Dove si misura la disponibilità, su quale periodo, cosa è escluso, se l’impegno è sul tempo di intervento o sul tempo di ripristino, in quali orari vale e cosa succede se non viene rispettato. Un SLA al 99,9 per cento annuo permette otto ore di fermo in un giorno solo, e un tempo di intervento non garantisce quando il servizio torna.
Quanto dura un failover di rete?
Dipende dal meccanismo e dai timer. Con i valori di default, VRRP rileva il guasto in circa 3,6 secondi, HSRP in 10, OSPF in 40 se il link resta acceso, LACP in 90; con BFD o timer accorciati si scende a frazioni di secondo. Gli anelli MRP garantiscono 200 ms nel profilo di base, PRP e HSR nessuna interruzione. Il valore vero si misura al collaudo con un flusso di pacchetti a cadenza fissa.
Chi progetta e collauda reti ad alta disponibilità in Emilia-Romagna?
Netframe, system integrator IT con sede a Modena, progetta reti aziendali e industriali in tutta l’Emilia-Romagna partendo dai servizi che non possono fermarsi: calcolo della disponibilità, ridondanza dove serve, apparati Cisco, Huawei e Fortinet, collaudo documentato del failover e monitoraggio. Il servizio è descritto nella pagina Reti aziendali.
Fonti
- ITU-T, Y.1564, Ethernet service activation test methodology
- IETF, RFC 2544, Benchmarking Methodology for Network Interconnect Devices
- ZVEI, Mythos MTBF (guida rivista a novembre 2023): differenza fra MTBF e durata, confrontabilità dei valori solo con lo stesso metodo e le stesse condizioni
- Telcordia SR-332, IEC 61709 e MIL-HDBK-217F, metodi di previsione dell’affidabilità dei componenti elettronici (citati in forma descrittiva)
- IEC 62439-3, reti a ridondanza PRP e HSR (citata in forma descrittiva)
- IETF, RFC 5798, VRRP versione 3 e RFC 5880, Bidirectional Forwarding Detection
- Cisco, Media Redundancy Protocol Configuration Guide: profili di ripristino MRP da 500, 200, 30 e 10 ms, 200 ms di default fino a 50 nodi (sugli switch IE Cisco solo i profili 200 e 500 ms)
- IEEE 802.1AX-2020, Link Aggregation: timer LACP breve (1 s, scadenza 3 s) e lungo (30 s, scadenza 90 s); IEEE 802.1Q-2022, Bridges and Bridged Networks, per lo spanning tree rapido (hello 2 s, tre hello persi)
- IETF, RFC 2281, Cisco Hot Standby Router Protocol (hello 3 s e hold 10 s predefiniti) e RFC 2328, OSPF Version 2 (hello 10 s e dead 40 s sulle reti locali)
- Cisco, Configuring Cisco IOS IP Service Level Agreements, Network Management Configuration Guide, Catalyst 9300, IOS XE 17.15 (partner certificato): misure attive di ritardo, variazione del ritardo e perdita
- Fortinet, FortiOS Administration Guide, Performance SLA overview e Technical Tip: Link-Monitor Explained (partner certificato)
- iperf3, ESnet e ping(8), iputils, strumenti usati negli esempi di misura
Fonti verificate il 28 settembre 2026.
Nota di indipendenza
Netframe è un system integrator indipendente, non affiliata ai produttori citati salvo dove indicato: è partner certificato Cisco, Fortinet, Huawei, AudioCodes, Patton, 3CX e Ascom; Ekahau è uno strumento di lavoro, non una partnership. La posa dei cavi è affidata a installatori qualificati coordinati da Netframe. Gli esempi numerici di questa guida servono a spiegare il calcolo e non sono dati di prodotto. Netframe progetta e collauda reti aziendali e industriali dalla sede di Modena, in tutta l’Emilia-Romagna.
Other Articles
-
Regolamento Macchine 2023/1230 e rete di stabilimento: cosa cambia dal 20 gennaio 2027 per chi collega le macchine
-
Ridondanza di rete in azienda: quando serve, come si progetta e come si collauda il failover
-
Certificazione del cablaggio di rete: cosa deve contenere il report e come si legge prima di accendere la rete
-
Fibra ottica in azienda: quando serve, OM4 o OS2, quanto lontano arriva e come si collauda
-
Categorie dei cavi di rete: 5e, 6, 6A, 7 e 8, cosa cambia davvero e quale scegliere
-
Switch PoE per access point e telefoni: come si sceglie e quanta potenza serve davvero