Ridondanza di rete in azienda: quando serve, come si progetta e come si collauda il failover
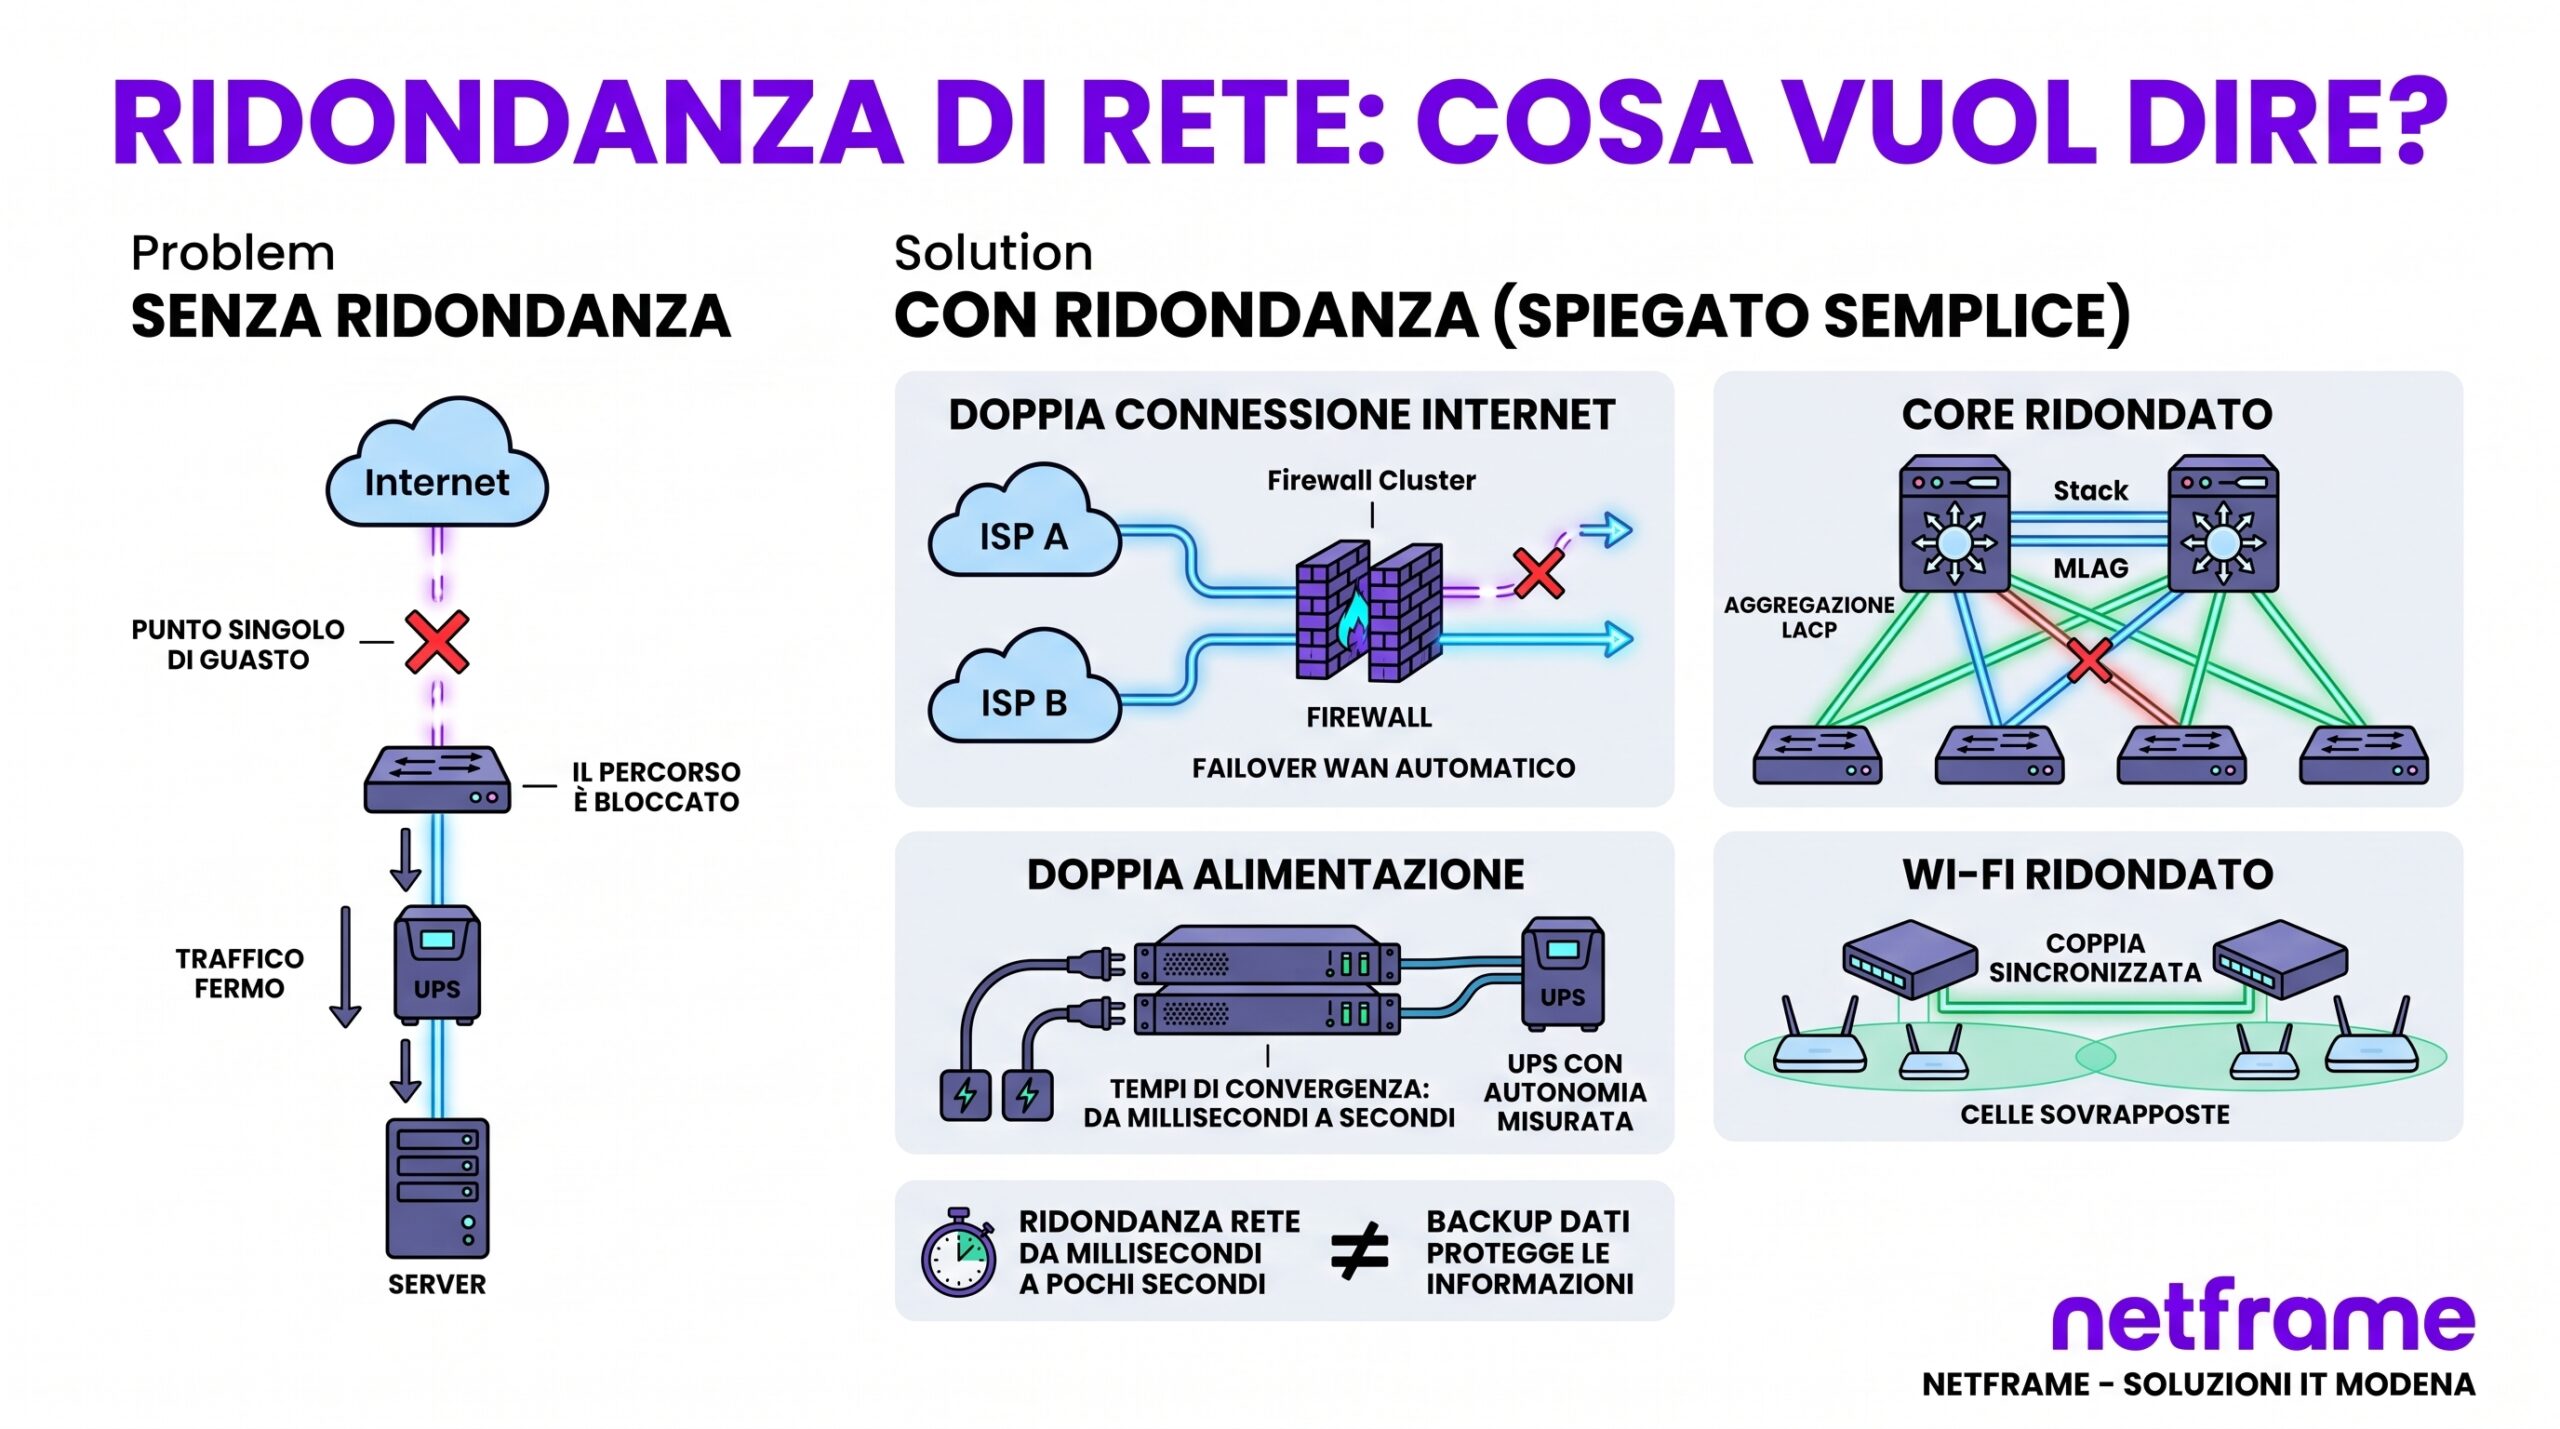
In breve. Ridondanza di rete vuol dire che ogni cosa da cui dipende la rete ne ha una seconda pronta a subentrare da sola, in un tempo misurato. Serve quando un’ora senza rete costa più della ridondanza: gestionale in cloud, telefoni VoIP (Voice over IP, la voce sulla rete dati) o Teams, magazzino su terminali Wi-Fi, più edifici. Si costruisce su cinque livelli: due connessioni di operatori diversi con failover automatico; un core fatto di due switch che lavorano come uno, con doppi collegamenti; UPS (Uninterruptible Power Supply, il gruppo di continuità) con autonomia misurata; controller Wi-Fi in coppia o gestione in cloud; trunk telefonico che funziona anche dalla seconda linea. Ogni meccanismo ha un tempo di passaggio tipico, da meno di un secondo fra gli switch a pochi secondi per il cambio di connessione, e va collaudato staccando davvero cavi e corrente.
Questa guida è scritta da Netframe, system integrator IT con sede a Modena, che progetta, installa e collauda la ridondanza nelle reti aziendali dell’Emilia-Romagna.
Ridondanza di rete: cosa vuol dire, spiegato semplice
Ridondanza di rete vuol dire che ogni cosa da cui dipende la rete ne ha una seconda pronta a subentrare. Due connessioni a internet invece di una, due switch al centro invece di uno, due alimentatori, due percorsi. Quando una si guasta, l’altra prende il suo posto, in automatico e in fretta, e le persone continuano a lavorare. Non è la stessa cosa dei backup dei dati, e non è nemmeno la ridondanza dei server: quelle proteggono le informazioni e le applicazioni. La ridondanza di rete protegge la strada che ci arriva.
Questa guida è per gli uffici, le PMI (piccole e medie imprese) e le sedi con più edifici. Spiega quando la ridondanza serve davvero, i cinque livelli su cui si costruisce, come funziona il failover e quanto ci mette. E spiega come si collauda, perché un failover mai provato è una speranza, non un progetto. Netframe la progetta e la installa nelle reti aziendali dell’Emilia-Romagna, dagli uffici ai capannoni. Per gli impianti industriali, dove i tempi di ripristino si contano in millisecondi e si usano gli anelli, la guida giusta è quella sulle reti industriali ad alta affidabilità. Per i casi a zero interruzione c’è quella su PRP e HSR (Parallel Redundancy Protocol e High-availability Seamless Redundancy, i protocolli della IEC 62439-3). Qui il perimetro è l’azienda che lavora con il gestionale, il telefono, Teams e il Wi-Fi.
Cos’è ridondanza e cosa non lo è
Un secondo router comprato e lasciato nell’armadio non è ridondanza: è un ricambio. Diventa ridondanza quando è collegato, configurato e capace di subentrare da solo. Due connessioni a internet che entrano nello stesso router non sono ridondanza del router. Sono ridondanza della linea, e se il router si spegne se ne vanno tutte e due. Due switch collegati fra loro con un cavo solo non sono un core ridondato: se quel cavo si stacca, la rete si divide in due. La ridondanza vera ha tre proprietà. Non c’è un punto singolo di guasto lungo il percorso che conta. Il passaggio avviene senza che una persona debba intervenire. E il passaggio è stato provato, con un tempo misurato.
Quando serve davvero
La domanda giusta non è “quanto costa” ma “quanto costa un’ora senza rete”. Per una piccola azienda che lavora sui file locali un’ora di internet in meno è fastidiosa. Per un’azienda con il gestionale in cloud, i telefoni su Teams e il magazzino sui terminali, un’ora senza rete è un’ora senza azienda.
| Scenario | Cosa si ferma senza rete | Ridondanza sensata |
|---|---|---|
| Ufficio con file in sede e posta in cloud | Posta e web; il lavoro sui file continua | Seconda connessione a internet, anche su rete mobile; UPS sugli apparati di rete |
| Sede con telefoni VoIP o Teams e gestionale in cloud | Telefoni, gestionale, videochiamate: quasi tutto | Doppia connessione con due operatori e failover automatico; core ridondato; UPS con autonomia misurata |
| Magazzino con terminali e carrelli su Wi-Fi | Prelievi e spedizioni | Core e alimentazione ridondati, gestione Wi-Fi che regge il guasto del controller, doppio percorso in fibra fra edifici |
| Più edifici sullo stesso sito | L’edificio staccato dalla dorsale | Due fibre su percorsi diversi verso ogni edificio, con i due capi su switch diversi |
| Evento o convention in streaming | La trasmissione, senza possibilità di rifarla | Connessione dedicata più una di riserva su operatore diverso, encoder doppio; vale per il giorno dell’evento |
La riga giusta la sceglie l’azienda, e conviene scriverla: qual è il tempo massimo di fermo che si accetta, per quale servizio. Da quel numero discende tutto il resto.
I cinque livelli della ridondanza
La rete si guasta in cinque punti diversi, e ognuno si protegge in modo diverso. Proteggerne uno solo sposta il problema.
1. L’accesso a internet
È il guasto più frequente, e il più facile da coprire. Servono due connessioni, e la parola che conta è “diverse”. Due operatori, e se possibile due tecnologie, per esempio fibra più radio o fibra più rete mobile 4G o 5G. Due linee dello stesso operatore sullo stesso cavo che entra nell’edificio cadono insieme al primo scavo stradale. Il firewall le tiene tutte e due e decide su quale mandare il traffico. La funzione si chiama SD-WAN (Software-Defined WAN; la WAN, Wide Area Network, è il collegamento verso l’esterno), o più semplicemente failover della WAN, ed è spiegata nella guida all’SD-WAN Fortinet per le PMI. Il firewall manda continuamente delle sonde verso un punto fisso di internet su ogni linea. Quando su una linea le sonde non tornano, sposta il traffico sull’altra.
Sui FortiGate la funzione si chiama Performance SLA (SLA, Service Level Agreement, il livello di servizio da rispettare). Con le impostazioni predefinite dichiara la linea inattiva dopo cinque sonde consecutive senza risposta, quindi il passaggio avviene in pochi secondi; i tempi si possono accorciare, al prezzo di qualche falso allarme in più su una linea disturbata. La linea di riserva su rete mobile va scelta con un contratto senza limiti di traffico, altrimenti il giorno del guasto finisce il credito.
2. Il core e la dorsale
Il core è il punto in cui tutto converge: gli switch di piano, il firewall, i server, i controller. Se è uno switch solo, è un punto singolo di guasto per l’intera azienda. La soluzione più diffusa nelle PMI è lo stack. Sono due o più switch collegati con cavi dedicati che si comportano come uno solo, con un controllo unico e uno switch di riserva che subentra se l’attivo si guasta. Cisco lo chiama StackWise e, nella documentazione dei Catalyst 9300, arriva a otto switch in anello con un piano di controllo unico. Huawei ha lo stesso concetto con iStack e CSS.
La variante per apparati più grandi è l’MLAG (Multi-Chassis Link Aggregation), in cui due switch indipendenti presentano ai vicini un unico collegamento aggregato. In tutti e due i casi ogni switch di piano si collega con un cavo a ciascuno dei due switch del core, e i due cavi sono aggregati con LACP (Link Aggregation Control Protocol, lo standard IEEE 802.1AX). Se uno si stacca, l’altro porta tutto.
È il backbone ridondato. In un sito con più edifici le due fibre della dorsale verso ogni edificio vanno su percorsi diversi e finiscono su due switch diversi. Altrimenti la ridondanza è solo sulla carta.
3. L’alimentazione
Una rete ridondata su un’unica linea elettrica cade tutta insieme al primo blackout. Gli apparati del core, il firewall e i controller vanno su un gruppo di continuità (UPS) con un’autonomia misurata, non stimata. Si stacca la corrente in prova e si legge quanti minuti reggono. Gli switch del core e i firewall in fascia alta hanno due alimentatori, da collegare a due prese su due circuiti diversi. Gli switch PoE (Power over Ethernet) di piano che alimentano telefoni e access point vanno anch’essi sotto UPS. Altrimenti al blackout i telefoni si spengono anche se la rete regge. Il dimensionamento del PoE va fatto contando i watt reali dei dispositivi collegati, come spiegato nella guida agli switch PoE per access point e telefoni.
4. Il Wi-Fi
Il Wi-Fi si guasta in due modi. Un access point che si spegne lascia un buco. La ridondanza è nel progetto della copertura (vedi quanti access point servono), con celle che si sovrappongono abbastanza perché i vicini coprano il buco a potenza maggiore. Il controller che si guasta è più grave, perché senza controller molti sistemi smettono di accettare nuovi client.
Si risolve in tre modi. Con un secondo controller in coppia, che tiene sincronizzato lo stato e subentra senza far cadere i client. È il caso delle configurazioni ad alta disponibilità dei controller Cisco. Con un controller in più rispetto al necessario, N+1, verso cui gli access point si spostano al guasto. Oppure con la gestione in cloud del produttore, in cui gli access point continuano a lavorare da soli se il cloud non risponde. La scelta dipende da quanti access point ci sono e da quanto la rete è critica.
5. La telefonia
La telefonia sta sopra tutto il resto: se cade la rete, cade lei. Qui la ridondanza specifica riguarda il percorso delle chiamate. Le linee SIP (Session Initiation Protocol, il protocollo della telefonia su rete dati) dell’operatore devono poter passare sulla seconda connessione a internet, e va verificato con l’operatore che il trunk funzioni da un indirizzo diverso. Il centralino in sede può essere in coppia, e l’SBC (Session Border Controller) che collega Microsoft Teams alla rete telefonica può essere doppio. Il centralino in cloud sposta il problema: non si guasta lui, ma la connessione per raggiungerlo, quindi la ridondanza della WAN è la sua ridondanza. Ne parliamo nella pagina sulla telefonia VoIP aziendale.
Failover automatico e manuale, e quanto ci mette
Cos’è il failover
Il failover è il passaggio dal percorso guasto a quello di riserva. È automatico quando lo decide un apparato in base a un controllo, e manuale quando lo fa una persona. La ridondanza manuale ha un senso solo se c’è sempre una persona presente e la procedura è scritta e provata. In tutti gli altri casi il failover deve essere automatico, perché i guasti arrivano di notte e nel weekend.
I tempi di convergenza
Ogni meccanismo ha un tempo tipico, e conviene conoscerlo prima di prometterlo.
| Meccanismo | Dove lavora | Tempo tipico di passaggio | Cosa se ne accorge |
|---|---|---|---|
| Aggregazione di link (LACP) e stack o MLAG | Fra switch di piano e core | Sotto il secondo, spesso sotto i 50 millisecondi | Nessuno |
| Spanning tree rapido (RSTP, Rapid Spanning Tree Protocol) | Reti con anelli di switch senza stack | Da meno di un secondo a qualche secondo | Una videochiamata può avere un singhiozzo |
| Gateway ridondato (VRRP, Virtual Router Redundancy Protocol; HSRP, Hot Standby Router Protocol di Cisco) | Indirizzo del gateway fra due router o firewall | Da pochi secondi a una decina con i valori predefiniti, meno se si accorciano i tempi | Qualche pagina da ricaricare |
| Cluster di firewall | Fra due firewall in coppia | Pochi secondi, con le sessioni mantenute se sincronizzate | Quasi nessuno |
| Failover della WAN (SD-WAN) | Fra le connessioni a internet | Pochi secondi per la rilevazione, più il tempo delle applicazioni per riconnettersi | Le chiamate in corso possono cadere, le nuove partono |
| Passaggio su rete mobile 4G o 5G | Riserva dell’accesso a internet | Da pochi secondi a qualche decina | Banda ridotta finché non torna la linea principale |
Un dettaglio che sorprende: il ritorno alla linea principale, quando si ripara, può fare più danno del guasto, perché le sessioni si spostano di nuovo. Il ritorno va configurato con un ritardo, così che una linea che va e viene non faccia rimbalzare il traffico dieci volte in un minuto.
I parametri che contano
I concetti sopra diventano ridondanza vera solo con i parametri giusti. Questi sono quelli che Netframe imposta nei progetti per le PMI, con il valore predefinito dei produttori e quello che conviene di solito. Vanno adattati impianto per impianto, e i nomi esatti dei comandi cambiano con la versione del software.
Accesso a internet e firewall
| Meccanismo | Parametro | Valore predefinito | Valore consigliato in una PMI | Effetto |
|---|---|---|---|---|
| Failover della WAN (FortiGate, Performance SLA) | Intervallo delle sonde; fallimenti prima dell’inattività; successi prima del rientro; aggiornamento delle rotte statiche | Sonde ogni mezzo secondo circa nelle versioni recenti; 5 fallimenti; 5 successi; aggiornamento attivo | Sonde ogni 500-1.000 ms; 3-5 fallimenti; 10-20 successi; aggiornamento attivo; due server di sonda diversi | Rilevazione in 2-5 secondi, rientro ritardato per non rimbalzare, nessun falso allarme se cade un solo server di sonda |
| Cluster di firewall (FortiGate FGCP, FortiGate Clustering Protocol) | Modalità; sincronizzazione delle sessioni; porte monitorate; ritorno automatico al nodo principale | Attivo-passivo; sessioni TCP (Transmission Control Protocol) sincronizzate se abilitato; nessuna porta monitorata; ritorno disattivato | Attivo-passivo; sessioni sincronizzate; WAN e LAN monitorate; ritorno disattivato; due cavi di heartbeat dedicati | Il passivo subentra in pochi secondi senza far cadere le sessioni; il cluster non rimbalza quando il primario torna |
Switch e gateway
| Meccanismo | Parametro | Valore predefinito | Valore consigliato in una PMI | Effetto |
|---|---|---|---|---|
| Stack (Cisco StackWise, Huawei iStack) | Topologia dei cavi di stack; priorità dello switch attivo; alimentazione condivisa | Priorità uguale, elezione automatica | Anello chiuso con due cavi; priorità esplicita per attivo e riserva; alimentazione condivisa dove disponibile | Un cavo di stack staccato non divide lo stack; il ruolo attivo è prevedibile |
| Aggregazione di link (LACP) | Modalità; algoritmo di distribuzione; timer | Dipendono dal produttore modalità e hash; timer lungo (30 s) | Attiva su tutti e due i lati; hash su indirizzi IP (Internet Protocol) e porte; timer breve (1 s) sugli uplink | Un link che resta acceso ma non passa traffico viene escluso in 3 secondi invece che in 90 |
| Spanning tree rapido (RSTP) | Priorità del root bridge; porte edge; protezione BPDU (Bridge Protocol Data Unit, i messaggi dello spanning tree) | 32768 ovunque, root eletto dal MAC (Media Access Control, l’indirizzo fisico) più basso | Root fissato sul core con priorità bassa; porte di accesso come edge; BPDU guard sulle porte edge | Riconvergenza sotto il secondo, nessun blocco delle porte utente, uno switch domestico collegato per sbaglio viene isolato |
| Gateway ridondato (VRRP, HSRP) | Intervallo dei messaggi; tempo di attesa; preemption con ritardo | VRRP 1 s, attesa circa 3,6 s; HSRP hello 3 s, attesa 10 s | Hello 1 s e attesa 3 s, o meno dove il produttore lo consente; preemption con ritardo di 60-120 s | Il gateway di riserva subentra in 3 secondi; il principale riprende solo quando ha finito di ripartire |
Wi-Fi e telefonia
| Meccanismo | Parametro | Valore predefinito | Valore consigliato in una PMI | Effetto |
|---|---|---|---|---|
| Controller Wi-Fi in coppia | Link di ridondanza; sincronizzazione dello stato | Non configurato | Cavo dedicato fra i due controller; stato sincronizzato; stessa versione software | Gli access point non si scollegano al guasto dell’attivo |
| Trunk SIP | Indirizzi sorgente accettati; tipo di registrazione; scadenza | Un indirizzo pubblico; registrazione con scadenza di un’ora | Due indirizzi pubblici dichiarati all’operatore, o trunk a registrazione; scadenza 60-120 s | Le chiamate ripartono sulla seconda linea entro la scadenza della registrazione |
Il dimensionamento dell’UPS
Si parte dai watt reali, non dalla targa. Un esempio per un armadio di core. Due switch da 48 porte PoE che assorbono 120 W ciascuno a vuoto, più 400 W di carico PoE fra i due. Un firewall da 60 W e un controller da 40 W. Fanno 740 W. Si aggiunge un margine del 25 per cento per crescita e picchi: 925 W. Si divide per il fattore di potenza dell’UPS, di solito 0,9: circa 1.030 VA (voltampere, la potenza apparente con cui si classificano gli UPS). Un UPS da 1.500 VA, in tecnologia online a doppia conversione, regge quel carico per una decina di minuti con le batterie interne. Per arrivare a 30-60 minuti serve il modulo batterie aggiuntivo. Il numero vero però è quello misurato al collaudo, e va rimisurato ogni anno, perché le batterie perdono capacità.
Il budget PoE
Per il conto si usa la classe PoE dei dispositivi collegati, non la loro media. Un telefono IP chiede 5-10 W. Un access point Wi-Fi 6 chiede fino a 25-30 W, in classe 4 (PoE+); i modelli Wi-Fi 6E e Wi-Fi 7 possono chiedere il PoE++. Una telecamera PTZ (pan-tilt-zoom, brandeggiabile) 15-25 W, un touchpanel 10-15 W. Lo standard IEEE 802.3 (IEEE, Institute of Electrical and Electronics Engineers) fissa alla porta 15,4 W per la classe di base, 30 W per il PoE+ e 60 o 90 W per il PoE++. La somma delle classi dei dispositivi deve stare dentro il budget dichiarato dello switch. Quello stesso budget va contato nel carico dell’UPS: è l’errore più comune quando al blackout la rete regge e i telefoni si spengono. I dettagli, classe per classe, sono nella guida agli switch PoE.
Una configurazione di riferimento
Per fissare le idee: una PMI da 50-100 persone su due edifici, con gestionale in cloud, telefoni VoIP e Teams, magazzino con terminali Wi-Fi. Lo schema che Netframe propone come base è questo.
Accesso, firewall, core e dorsale
- Accesso a internet: fibra dell’operatore A più radio o 5G dell’operatore B, tutte e due sul cluster di firewall, con SD-WAN in modalità di riserva e le sonde della tabella sopra. Il traffico voce e Teams su regole SD-WAN con soglie di latenza e perdita, così che passi sulla seconda linea anche quando la prima è degradata e non solo quando è morta.
- Firewall: due apparati in cluster attivo-passivo, con sessioni sincronizzate, due cavi di heartbeat e porte WAN e LAN monitorate.
- Core: due switch in stack ad anello nell’edificio principale. Ogni switch di accesso ha due uplink, uno per membro dello stack, aggregati in LACP con timer breve.
- Dorsale verso il secondo edificio: due fibre monomodali su percorsi diversi, terminate su due membri diversi dello stack e su due switch diversi dall’altra parte, aggregate o con RSTP e root fissato sul core.
Alimentazione, Wi-Fi, telefonia e servizi di rete
- Alimentazione: UPS online per ogni armadio, dimensionato come sopra e con autonomia misurata; doppio alimentatore su core e firewall, su due circuiti.
- Wi-Fi: due controller in coppia con stato sincronizzato, oppure gestione in cloud con access point che continuano a lavorare senza cloud. Celle sovrapposte perché il guasto di un access point non lasci buchi nelle corsie del magazzino.
- Telefonia: trunk SIP accettato dall’operatore da tutti e due gli indirizzi pubblici, o a registrazione con scadenza breve; centralino in sede in coppia o centralino in cloud; per Teams, SBC in coppia.
- Servizi di rete: DHCP (Dynamic Host Configuration Protocol, che assegna gli indirizzi) e DNS (Domain Name System, che risolve i nomi) su due server, o sul cluster di firewall, perché una rete fisicamente ridondata con un solo DHCP si ferma lo stesso quando scadono gli indirizzi.
È uno schema di partenza, non un capitolato: ogni voce si dimensiona sul tempo massimo di fermo scritto all’inizio.
Come si collauda
Un failover mai provato è una speranza, non un progetto. Il collaudo si fa a rete accesa, con un piano scritto, e si ripete una volta l’anno.
1. Si stacca la linea principale
Con una telefonata in corso e una videochiamata aperta. Si misura in quanti secondi il traffico passa sulla seconda linea, cosa è caduto e cosa no. Poi si riattacca, e si misura anche il ritorno.
2. Si spegne uno switch del core
Con il traffico reale. Si verifica che gli switch di piano, il firewall e i server restino raggiungibili, e per quanti secondi qualcosa manca.
3. Si toglie la corrente
Si stacca l’alimentazione all’armadio e si legge quanti minuti regge il gruppo di continuità con il carico vero. Se sono meno di quelli promessi, le batterie sono da cambiare.
4. Si spegne il controller Wi-Fi
Con un telefono Wi-Fi in chiamata e un portatile in uso. Si verifica che i client restino collegati o si ricolleghino, e in quanto tempo.
5. Si scrive il rapporto
Per ogni prova: cosa si è staccato, quanti secondi di interruzione, cosa è caduto, cosa si è corretto. È il documento che dice, un anno dopo, se la ridondanza c’è ancora.
I guasti da provocare e cosa aspettarsi
| Guasto provocato | Meccanismo che deve rispondere | Tempo atteso | Criterio di superamento |
|---|---|---|---|
| Cavo della linea principale staccato | Failover della WAN | 2-10 secondi | Le nuove chiamate e le nuove sessioni partono sulla seconda linea; si annota quali sessioni in corso sono cadute |
| Linea principale degradata (perdita di pacchetti simulata) | Regole SD-WAN con soglie di qualità | Entro il tempo delle sonde | Voce e Teams passano sulla seconda linea prima che gli utenti se ne accorgano |
| Firewall attivo spento | Cluster | Pochi secondi | Le sessioni TCP in corso sopravvivono; il tunnel VPN (Virtual Private Network) si rialza |
| Switch attivo dello stack spento | Switchover dello stack | Sotto il secondo | Nessuna chiamata caduta, nessun access point scollegato |
| Un uplink LACP staccato | Aggregazione | Sotto il secondo | Nessuna perdita percepita; il traffico passa sull’altro cavo |
| Una fibra della dorsale staccata | Aggregazione o RSTP | Sotto il secondo, fino a qualche secondo con RSTP | Il secondo edificio resta raggiungibile; si annota il tempo |
| Corrente tolta all’armadio | UPS | Autonomia dichiarata | Minuti misurati con il carico vero non inferiori a quelli scritti nel progetto |
| Controller Wi-Fi attivo spento | Coppia sincronizzata, N+1 o cloud | Sotto il secondo in coppia; 30-60 secondi con N+1 | Il telefono Wi-Fi in chiamata non cade (coppia) o si ricollega entro il tempo atteso (N+1) |
| Trunk SIP forzato sulla seconda linea | Registrazione o indirizzi dichiarati | Entro la scadenza della registrazione | Chiamate in ingresso e in uscita funzionanti dalla seconda linea |
Gli errori che si trovano più spesso
- Due linee dello stesso operatore, sullo stesso cavo, che cadono insieme.
- Doppia connessione su un solo firewall, con il firewall come punto singolo di guasto.
- Due switch al core collegati con un cavo solo.
- Fibre ridondate fra due edifici posate nello stesso cavidotto.
- UPS con autonomia scritta sull’etichetta e mai misurata, con le batterie di sette anni.
- Switch PoE di piano senza UPS: al blackout la rete regge e i telefoni si spengono.
- Linea di riserva su rete mobile con il traffico a consumo, finito il primo giorno di guasto.
- Trunk SIP che funziona solo dall’indirizzo della linea principale.
- Failover configurato e mai provato, scoperto rotto il giorno del guasto.
- Ritorno alla linea principale senza ritardo, con il traffico che rimbalza a ogni sbalzo.
Domande frequenti sulla ridondanza di rete
Quando serve la ridondanza di rete?
Quando un’ora senza rete costa più della ridondanza. È il caso di ogni azienda con il gestionale in cloud, i telefoni VoIP o su Teams, il magazzino su terminali Wi-Fi, o più edifici collegati da una dorsale. Il criterio è il tempo massimo di fermo accettabile per ciascun servizio, scritto prima del progetto. Da quel numero discendono i livelli da ridondare e i tempi di failover da garantire.
Cos’è il failover?
È il passaggio automatico dal percorso guasto a quello di riserva, deciso da un apparato in base a un controllo continuo. Il controllo può essere una sonda verso internet per le linee, il cavo di stack o LACP fra switch, un messaggio fra due firewall o due controller. Ogni meccanismo ha un tempo tipico, da meno di un secondo per stack e LACP a pochi secondi per il failover della WAN. Il failover manuale ha senso solo con una persona sempre presente e una procedura scritta e provata.
Serve la ridondanza di rete per uno streaming o un evento?
Sì, per il giorno dell’evento. Una convention trasmessa in streaming ha bisogno di una connessione dedicata, separata da quella degli uffici, più una di riserva su un operatore o una tecnologia diversa. Serve poi un encoder doppio che passi dall’una all’altra. È una ridondanza temporanea, che si monta e si prova prima dell’evento. Vale più della ridondanza permanente, perché uno streaming interrotto non si può rifare.
Che differenza c’è fra ridondanza di rete e ridondanza dei server?
La ridondanza dei server protegge le applicazioni e i dati: due server in cluster, dischi ridondati, backup. La ridondanza di rete protegge la strada per arrivarci: connessioni, switch, alimentazione, Wi-Fi, telefonia. Sono indipendenti, e servono tutte e due. Un server in cluster dietro un solo switch è fermo quanto lo switch, e una rete ridondata davanti a un server solo non salva il server.
Quanto ci mette un failover?
Dipende dal meccanismo. Stack, MLAG e aggregazione LACP passano sotto il secondo, spesso sotto i 50 millisecondi. Lo spanning tree rapido va da meno di un secondo a qualche secondo. Un gateway ridondato con VRRP o HSRP impiega da pochi secondi a una decina con i valori predefiniti. Il failover della WAN rileva il guasto in pochi secondi, e poi le applicazioni devono riconnettersi. La riserva su rete mobile impiega da pochi secondi a qualche decina. I numeri veri sono quelli misurati al collaudo.
Chi progetta la ridondanza di rete per le PMI in Emilia-Romagna?
Netframe, system integrator IT con sede a Modena, progetta e installa la ridondanza di rete per uffici, PMI e sedi con più edifici in tutta l’Emilia-Romagna. Realizza la doppia connessione con failover su firewall Fortinet, il core in stack Cisco o Huawei, l’alimentazione con UPS e doppi alimentatori. Progetta il Wi-Fi con controller in coppia o gestione in cloud, e la telefonia VoIP e Teams sul doppio percorso. Ogni progetto si chiude con il collaudo del failover e con il rapporto dei tempi misurati.
Fonti
- Fortinet, FortiOS Administration Guide, Link health monitor e Technical Tip: Link-Monitor Explained: sonde ogni 500 ms, 5 fallimenti e 5 successi come valori predefiniti, rimozione delle rotte al guasto; FortiOS 7.6 Administration Guide, Session pickup per la sincronizzazione delle sessioni nel cluster FGCP (partner certificato)
- Cisco, Catalyst 9300 StackWise System Architecture: stack fino a otto switch in anello, piano di controllo unico, switch attivo e di riserva (partner certificato)
- Huawei, documentazione delle soluzioni campus: stacking iStack e CSS, aggregazione dei link (partner certificato), citata in forma descrittiva
- IEEE 802.1AX-2020, Link Aggregation (LACP); IEEE 802.1Q-2022, Bridges and Bridged Networks, per lo spanning tree rapido; IETF RFC 5798, Virtual Router Redundancy Protocol versione 3: intervallo predefinito di 1 secondo e tempo di attesa di 3 intervalli più lo skew
- IEEE 802.3, clausola 33 (PoE e PoE+) e clausola 145 (802.3bt-2018, PoE++): potenze alla porta per classe (15,4, 30, 60 e 90 W)
Fonti verificate il 24 settembre 2026.
Nota di indipendenza
Netframe è un system integrator indipendente, non affiliata ai produttori citati salvo dove indicato: è partner certificato Fortinet, Cisco, Huawei, AudioCodes, Patton, 3CX e Ascom; Microsoft è technology partner. I tempi di failover e i parametri indicati sono valori tipici, cambiano con le versioni software dei produttori e vanno misurati al collaudo di ogni impianto.
Other Articles
Certificazione del cablaggio di rete: cosa deve contenere il report e come si legge prima di accendere la rete
Fibra ottica in azienda: quando serve, OM4 o OS2, quanto lontano arriva e come si collauda
Categorie dei cavi di rete: 5e, 6, 6A, 7 e 8, cosa cambia davvero e quale scegliere
Switch PoE per access point e telefoni: come si sceglie e quanta potenza serve davvero
Wi-Fi per gli ospiti in azienda: come si fa una rete guest che non apre la porta a nessuno
FortiGate in alta disponibilità: due firewall in coppia, così l’azienda non si ferma se uno si guasta